エンバインド株式会社 代表取締役
小林昌弘
有限会社 WINGSプロジェクトが運営する、テクニカル執筆コミュニティ(代表:山田祥寛)に所属するテクニカルライター。 Javaでのアプリケーションサーバ開発や社内フレームワーク開発、SaaS提供企業などの技術基盤の設計・開発を経験。サーバーサイドからスマホアプリ、P2Pを用いたリアルタイムコミュニケーション技術まで、基本レイヤーから応用まで広くカバーするフルスタックの技術力を強みとする。近年では、自社保有データの有効活用やRAG実装を支援する「生成AIソリューション」に加え、OCRやPDF生成といったデジタルとアナログ(紙)を繋ぐ中間ソリューション、データ分析技術を軸に、新規サービスの立ち上げから既存システムのリニューアル支援まで幅広く牽引。
監修
山田 祥寛
静岡県榛原町生まれ。一橋大学経済学部卒業後、NECにてシステム企画業務に携わるが、2003年4月に念願かなってフリーライターに転身。Microsoft MVP for Visual Studio and Development Technologies。執筆コミュニティ「WINGSプロジェクト」代表。主な著書に『「独習」シリーズ』、『改訂新版 これからはじめるReact実践入門』、『改訂3版 JavaScript本格入門』、他。
はじめに
第1回では、AIと親和性の高い「垂直型開発」が、手元の開発スピードを飛躍的に向上させる一方で、構造の選択にはメリットだけでなく、見過ごせないデメリットも存在することをお伝えしました。「垂直」のスピードと「水平」のガバナンスは、常にトレードオフの関係にあります。どちらか一方が正しいというわけではありません。
第2回となる本稿では、AIによる量産スピードを活かしつつ、システム全体の堅牢性を保つための解決策を提示します。人間がすべてのコードを書く時代を終わらせ、人間とAIの役割分担を軸とした、AI時代だからこその「水平構造」をどのように設計するのかについて、さらに掘り下げていきます。
いずれ生じる崩壊への懸念
現場でAIを導入しようとする初期フェーズでは、「既存の重厚な水平構造(三層構造など)を維持したままAIを適用する」のは、非常にハードルが高いのが現実です。手軽に試すことができ、成果も出やすい「垂直に閉じられた構造」からAI化をスタートさせるのは、現場の選択として極めて自然であり、避けにくいプロセスとも言えます。
しかし、ここには決定的な罠が潜んでいます。
垂直分割によって手元の開発スピード(ローカルな生産性)が向上すると、その効果に満足してしまいがちです。無原則に垂直化を進めてしまうと、やがてシステム全体の不整合という「崩壊」を招く可能性があります。
ここで注意したいのは、この崩壊が「AIのハルシネーション(出力ミス)」によって起きるのではないという点です。仮にAIが個々の機能について毎回100点満点の完璧なコードを出力し続けたとしても、将来的な崩壊は避けられません。
なぜなら、AIが肩代わりしてくれるのは、あくまで個別機能の「実装スピードや局所的な知識」であり、「システム全体におけるデータの整合性やガバナンス(グローバルな健全性)」まで保証してくれるわけではないからです。従来の水平フレームワークが長年守ってきた本質的な価値とは、単なるコードのお作法ではありません。共通の規律を通じて、システム全体の健全性を維持することにあります。
水平構造のガバナンスを捨てて垂直化を突き進めた場合、機能単位(顧客更新や決済ルールなど)では正しく動いているように見えても、AIによる小さな「設計や出力のブレ」がプロジェクト全体に徐々に蓄積していきます。
そして、ドメインの複雑性が増したとき、まず「人間側」が耐えきれなくなります。AIが生成した膨大なコードの全体像を誰も把握できなくなり、修正やデバッグのコストが爆発的に増大するからです。
最終的には、「なぜか動いているが、誰も全体の正しい仕様や責任を把握できない巨大なブラックボックス」になってしまいます。
「水平のままAIを導入するのは難しく、垂直のまま突き進めばいずれ崩壊する」――現場のリーダーたちが抱くこの懸念は、まさに正しいと言えるでしょう。だからこそ、垂直のスピードと水平のガバナンスを融合させる、新たな設計思想が求められているのです。
AI時代の「防衛線(ガードレール)」としてのバックエンド
ここまでシステム全体の構造論を展開してきましたが、本連載のテーマは「バックエンドのアーキテクチャ」です。ここで改めて、これからのバックエンドが果たすべき役割について考えてみましょう。
現在、AIツールの進化における目覚ましいトレンドの一つが、「フロントエンド領域を中心としたAI自動生成」です。
APIのインターフェース定義やデザインシステム、おおまかなUI/UXの要件をプロンプトとして与えれば、画面のHTMLやUIコンポーネントをAIが自動で高い精度でつくり上げられる時代になっています。今や画面(フロントエンド)は、「つくっては捨て、AIで素早く自動再生成すればいい」という、より流動的な扱いへと変化しつつあります。
ここで注意したいのは、現代のWebフレームワーク(Next.jsなど)の進化により、フロントエンド側でサーバー処理(Server Actionsなど)まで記述できるようになっていることです。そのため、「画面側の実装ですべてのバックエンドまでカバーできている」と錯覚しがちです。しかし、画面に紐づくデータ取得処理と、システム全体のデータ整合性を守るバックエンドアーキテクチャは、まったく別のものです。
では、フロントエンドが流動化し、自動生成の流れがさらに進んだとき、システム全体の安全性を担保する「防衛線(ガードレール)」はどこになるのでしょうか。その答えが、画面側のロジックから切り離された、独立した「バックエンド(コアロジックとガバナンス)」の存在です。そして、その価値は今以上に高まっていくはずです。
AIがどれほど洗練された見た目のUIや画面側の処理を自動生成できるようになったとしても、認可の漏れた不正なリクエストや、ビジネスルールに反するデータの不整合を100%遮断する絶対的な壁として、バックエンドは機能しなければなりません。
だからこそ、これからのバックエンド開発とは、「処理をAIに丸投げして自動作成させる領域」ではありません。設計者がAIを思考のパートナー(壁打ち相手)とし、自社の業務ノウハウや複雑な例外処理、エッジケースを徹底的に対話しながら言語化し、それらを堅牢に組み上げていく。これからのバックエンドは、より重要な領域になるはずです。
組織において、経営の核心を握る「ベテラン」、現場の手本を示して量産を指揮する「中堅」、泥臭い実装作業を担う「新人」という役割分担と権限委譲が存在するように、バックエンドのコードにも、「どこを人間の領域として死守し、AIにどこまでの権限を与えるか」というガバナンス設計が必要不可欠となります。
新・三層構造:AIとの分業を前提とした「水平パイプライン構造」
AIの爆速な量産スピード(垂直)を活かしつつ、バックエンドに不変の規律(水平)をもたらすには、システムをどのように再構築すべきなのでしょうか。
その答えとして筆者が提案するのが、目的や責務に応じてAIの役割(フェーズ)を明確に切り分け、それらをつなぐ「水平パイプライン構造」です。
「一括処理」から「パイプライン管理」へ
多くの現場が最初に試み、そして壁にぶつかるのが、「画面仕様からDB制約、ビジネスルールまで、あらゆる要求を1つのプロンプト(コンテキスト)に詰め込み、AIに一括でコードを出力させようとする」アプローチです。
たとえルール定義ファイルやプロンプト指示を緻密に組み上げ、AIを一時的に仕様へ忠実に従わせることができたとしても、「ドメインの正確性」「アーキテクチャの統一感」「保守性の高いコード記述」といった多角的な要求を、単一のAI(単一の処理フェーズ)だけで同時にすべて満たし続けることは極めて困難です。
要求を詰め込めば詰め込むほどコンテキストは混線し、局所的には正しく見えても、システム全体としてはデータ不整合やブラックボックス化を招いてしまいます。
開発組織の比喩を繰り返しますが、「ベテラン」「中堅」「新人」という役割分担は、まさにこのブラックボックス化の防止として機能していました。人間が担ってきた作業をAIに置き換えている以上、その思考法が当てはまるのは当然と言え、それぞれの役割をより明確に定義したコンテキスト設計こそが極めて有効なアプローチになるはずです。
一度の処理ですべてを解決する「一括(バッチ)処理型」から、それぞれのフェーズに最適な役割(人間が守るべき設計/AIに委任する量産)を与え、処理を段階的に連携させる「パイプライン管理」へ移行します。人間が設計した各フェーズを「つなぎこんでいく」ことで、初めてシステムの一貫性を保ちながら、AIの爆速な量産スピードを安全に享受できるようになります。
「技術的パイプライン」ではなく「概念的パイプライン」を組む
ここで筆者が提案する「パイプライン管理」とは、ミドルウェアを組んだり、CI/CDを整備したりといった「技術的なデータパイプライン」のことではありません。人間とAIが協調してコードを組み上げていくための「思考と役割のフェーズ(概念的パイプライン)」を設計することを意味します。
一括生成の失敗は、性質の異なるタスクを1つのコンテキストで一度にAIに解かせようとすることにあります。そうではなく、開発の思考プロセスを「概念的なフェーズ」に分解し、直列にバトンを渡していくのです。
機能ごとにバラバラなプロンプトで垂直に閉じさせるのではなく、システム内のあらゆる機能が、この共通した「役割のフェーズ(層)」を通過する。個別の機能を超えてシステム全体に共通の規律をもたらすからこそ、このパイプラインはAI時代における新たな「水平構造」として機能するのです。
パイプラインにおける3つのレイヤー設計
この「パイプライン管理」の思想に基づき、人間とAIがスムーズに協調できる3つのレイヤー(役割分担)を定義します。これは、従来の三層構造を「技術的な関心の分離」ではなく、「人間が死守すべき主権(規律)」と「AIに委任すべき領域(量産)」というAI時代の文脈で再解釈・再構築したものです。
概念的パイプラインの視点で捉えると、実際の処理フローは下図のように、両端の「汎用技術(入力・出力制御)」が外枠となり、その内側で「アプリケーション層(ワークフロー)」と「コアロジック層(独自ビジネス)」を通過していくパイプライン構造を描きます。外側の汎用的な処理(定型コード)をAIに任せつつ、内側の業務仕様や独自ロジックを人間とAIの協調で組み上げていくイメージです。
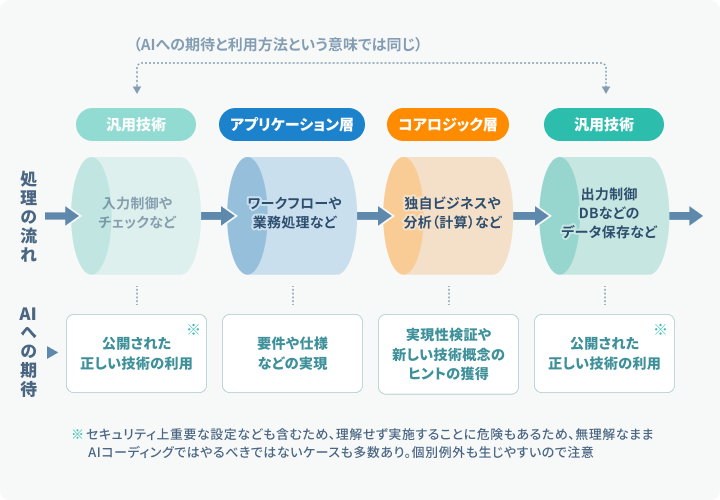
この流れを踏まえた上で、それぞれのレイヤーの具体的な役割とAIの活用方法を見ていきましょう。
アプリケーション層(プロンプト・手本層)
この層は、具体的な業務手順(ワークフロー)を記述する場所です。AI時代において、人間がここに直接コードを手書きする量は、最小限に留めるのが望ましいでしょう。
なぜなら、この領域は技術的な実装難易度自体は決して高くない一方で、業務機能ごとに「似ているが完全に同一ではないボイラープレートコード」が大量に発生しやすい性質を持っているからです。だからこそ、業務仕様や手順の詳細はコード内にベタ書きするのではなく、可能な限り「プログラムの外側(プロンプトや定義データ)」で管理できる状態を目指すべきです。
つまり、コードを直接書くのではなく、1つ上の抽象度から構造やルールを制御する「メタ視点でのプログラミング」こそが、AIをスムーズに乗りこなす鍵となります。
ここで重要になるのが、「そのメタ情報をコードやプロジェクトのどこに、どのようなルールで配置するか」という作法(メタ構造)を、あらかじめ定義しておくことです。
ここでいう「メタ情報」とは、プログラミング言語が標準で提供する高度なアノテーション(デコレーター)機能などに限定されるものではありません。たとえば筆者であれば、「APIとして公開するメソッドには必ず xxxxxAction() という名称を付与する」といったように、フレームワーク側で制限されていなくても、チーム内やプロジェクト内で明確なルール(作法)を設けています。
かつてであれば、こうしたルールはコーディング規約のドキュメントとして作成し、人間同士で共有していました。しかし、現代のLLMは極めて優秀であり、人間が作成した最小限の「手本コード」から、こうした命名規則や構造の意図(メタ情報)を自律的に読み取ることができます。
したがって、人間が行うべき作業は、「手書きした最小限の手本コードから、AIが意図どおりのルールや仕様ドキュメントを正しく逆引き(抽出)できるか」を確認することです。
手本コードからAIが正しく意図を汲み取れることを確認できたら、あとは各業務仕様(定義文やプロンプト)を流し込んで自動生成させていくだけです。この作法を一度確立してしまえば、AIは統一されたルールに従ってコードを爆速で縦展開してくれます。結果として、後から人間がコードを読んだり保守したりする際にも、全体の見通しが劇的に良くなるのです。
コアロジック層
ここは、簡単に言えば「世の中のAIが指示一発で出せるほど汎用的ではなく、自分たちにとってもまだ正解が分かっていない独自領域」、そして何より「不整合や破壊が絶対に許されない、最も重要なデータを直接取り扱う領域」のことです。また、自社特有の強みや競争優位性として秘匿・厳重管理しておきたいユニークな技術やデータルールも、ここに含まれます。
システム開発において、単なるプログラムコードのバグであれば、修正してデプロイし直せば解決できます。しかし、データベース内のデータそのものを破壊したり、整合性を欠いた不正データを蓄積させてしまったりした場合、あとから気づいても復旧は極めて困難です。AIによる爆速開発で得られたスピードのメリットも、一度の事故による負債や損害によって、一瞬で吹き飛んでしまうほどです。
現実的な制約としても、いくらAIを使いたいからといって、「既存の本番データや顧客データをAIに入力させて自動コーディングさせる」わけにはいかないという、セキュリティやガバナンス上の高い壁があります。AIが提示する一見それらしいコードによって、暗黙のデータ制約やトランザクションの一貫性が壊されるリスクを、現場が安易に受け入れるべきではありません。
だからこそここは、「仮にAIで生成できそうな処理であっても、人間が主権を持ち、手書きと深い思考で共通資産として定義・死守すべき領域(=AIでできてもやるべきではない領域)」と定義します。
では、この領域でAIをどう使うべきなのでしょうか。
ここでは、コード生成器としてではなく、「二人三脚で対話する思考の壁打ち相手(ペアプログラミングのパートナー)」としてAIを活用します。自分たちが手探りで定義した独自ルールやデータ構造(仮説)をAIに提示し、
「このルールやデータ構造だと、こういう特殊な顧客ケースでデータの不整合が起きないか?」
「他に考えられる例外やトランザクションの破綻はあるか?」
と対話させます。
AIにあえて「文脈的負荷(仮説)」を与え、思考プロセスを自己解説(デバッグ)させることで、人間だけでは気づけなかったデータの穴やエッジケースを事前に見つけ出し、ビジネスとデータ構造の解像度を極限まで高めていくことができるのです。
汎用技術・ツール連携層
前述の「独自ルール(コア)」とは対照的に、この層は「調べれば使い方はすぐに分かるが、人間がいちいち仕様やドキュメントを調べるのが圧倒的に面倒な領域」です。
具体的には、ORMのクエリ記述、JSONの整形、サードパーティ製SaaS/SDKの呼び出し、UIライブラリに合わせたデータ変換といった、「汎用技術や他者ツールの作法」が該当します。これらは難解な思考を要するわけではなく、ライブラリごとの「泥臭いお作法」に過ぎません。人間がこうした他者ツールのマイナーチェンジやお作法を追い続けるのは非効率であり、AIに全面的に委任(丸投げ)すべき領域と言えます。
ただし、この層をAIに任せる上で、絶対にしてはならないのがコードのブラックボックス化です。
そのためには、「プログラムのスタート(入口)とゴール(出口)が、誰の目にも明示的にたどれる状態」にしておくことが重要です。上から下へと処理が直列につながる、明確な追跡性(トレーサビリティ)を確保することこそが、ブラックボックス化を防ぐ鍵となります。先ほどのアプリケーション層で触れた xxxxxAction() のようなルールに従わせるのも、プログラムのスタート位置を誰にとっても明確にするためです。
既存のモダンなフレームワークでは、「コードの深い部分でサービス登録をすれば、裏で暗黙的に機能が使える」「グローバルなイベントフックで処理が飛ぶ」といった「便利な魔法」が重宝されてきました。人間がフレームワークのしきたりやトレンドに精通していた時代には、こうした手法が優れている部分も多々ありました。
しかし、AIにコードを書かせる環境で一度このイベントフックなどの利用を許すと、AIは手軽さゆえにフックを多用し始め、最終的には「どこで何が起きているか誰も管理できないスパゲッティ構造」へと一気に崩壊する可能性があります。
だからこそ筆者は、フレームワークのしきたり(暗黙のルール)を多少破ってでも、スタート地点からコードが明示的につながり、追える明瞭な書き方を優先しています。「フレームワークの特殊な文法やお作法を知らない人間(あるいはAI)が見ても、コードを上から下へ素直にたどれるか」という視点こそが重要なのです。
そして、AIによるコード生成が完了したら、最後の大切な仕上げを行います。その完成形コードをベースに、「使い方事例やドキュメント」をAI自身に逆作成(リバースドキュメント)させるのです。
コード記述をAIに任せつつも、「明示的なコード接続」と「AIによるドキュメント逆作成」をセットで行うことで、ブラックボックス化を完全に防ぎ、人間がいつでも安全にコントロールできるガバナンスが完成します。
まとめ
本稿では、無原則な垂直分割がもたらす「全体の崩壊」という懸念に対し、AIとの分業ポイントを明確にするための「概念的パイプライン構造」を提案しました。
しかし、ここまでの議論は、あくまで「単一のシステム・サービス内」に閉じた話に過ぎません。この概念的パイプラインの思想をさらにスケールさせ、複数のサービスへ展開しようとしたとき、私たちは「マイクロサービス」で生じる課題にぶつかります。
次回は、この問題について深掘りします。