人類はもはやAIには勝てないかもしれない。スタンフォード大学が毎年発行している「Artificial Intelligence Index Report」の2026年版の冒頭に掲げられている15のポイントの冒頭には次のように書かれている。
「AIの能力向上は停滞していません。むしろ加速しており、かつてないほど多くの人々の間に広がっています。…それらのモデルのいくつかは今や、PhD(博士)レベルの科学的質問、マルチモーダル推論、競技数学において、人間の基準(ヒューマン・ベースライン)に到達またはそれを上回っています。主要なコーディングベンチマークである「SWE-bench Verified」では、人間基準の達成度がわずか1年で60%から100%近くにまで上昇しました」。
AIはすでに言語処理、知識量、論理的推論、標準化されたテストなどの領域では、人間の能力を凌駕している。つまり、学校の定期試験で、人間とAIが競い合ったらAIの圧勝になるのだ。人間が活躍できるのは、体育の時間と給食の時間ぐらいしか残っていない。

ITジャーナリスト
牧野 武文(まきの たけふみ)
生活とテクノロジー、ビジネスの関係を考えるITジャーナリスト、中国テックウォッチャー。著書に「Googleの正体」(マイコミ新書)、「任天堂ノスタルジー・横井軍平とその時代」(角川新書)など。
人類の「反撃」が始まっている
中国の復旦大学では、ユニークな期末試験が実施された。
データマイニング技術を教える肖仰華教授は、期末試験の出題に頭を悩ませていた。データマイニングという学科の性質上、どんな出題をしても人間よりAIの方が早く正確に解いてしまう。学生を教室に閉じ込め、AIが使えない状態にして、AIでも解けるような問題を解かせて成績をつけるというのもおかしな話だ。これでは理解力を測ることにならず、単なる暗記力の試験になってしまう。AIを使って解ける問題は、どんどんAIを使って解けばいい。しかし、そうなると期末試験の問題がつくれない。
そこで、肖教授は発想を逆転させ、「学生に、AIが解けない、あるいは誤答する問題を考案させ、これをAIに解かせてみて、打ち負かすと得点になる」というまったく新しく大胆な期末試験を実施した。
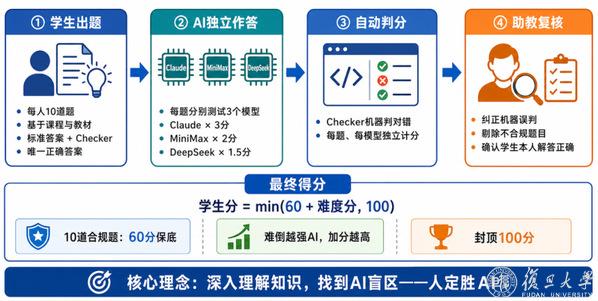
使用するAIモデルは「DeepSeek V4-Flash」「MiniMax M2.7」「Claude Sonnet 4.6」の3つ。学生が考案したデータマイニング関連の問題を10問、これらのAIに解かせ、AIが誤答すれば学生の得点になる、というルールだ。10問を用意した学生にはまず60点(最低合格点)が与えられ、そこからDeepSeekを打ち負かすごとに+1.5点、MiniMaxなら+2点、Claude Sonnetなら+3点が加点される。考案した10問すべてで3つのAIをすべて打ち負かせば60+15+20+30=125点になる計算だが、上限は100点と定められており、実際の得点はそこで頭打ちになる。
試験に参加した学生は51名。そのうち50名は、少なくとも1問でAIに誤答させることができた。一度もAIを打ち負かせなかった学生はわずか1名だった。さらに、特定のモデルを10問すべてで誤答させ、そのモデルを完封した学生は4名いた。ただし、3つのモデルの中で最も高性能とされるClaude Sonnetを完封した学生は一人もいなかった。51人の平均点は85.7点となり、肖仰華教授が予想していたよりも、学生たちは健闘したようだ。
学生たちは、各人各様のアプローチでAIを打ち負かしていった。肖仰華教授の講義を受講しているAさんは、物量でAIを追い詰める戦略を取った。AIの弱点は、短期的な記憶容量が小さいことだ。大量の情報を与えると、最初の情報を忘れてしまい、ハルシネーションを起こすことがある。
そこで、Aさんは数万件のデータをAIに読み込ませたうえで、答えを小数点4桁まで求めさせる問題を考案した。
Bさんは、AIがメタ認知を苦手とすることに目をつけた。彼はAからEまでの5つの選択肢を選ぶ問題を考案した。Eは「いずれでもない」という否定の選択肢だ。そして、重要な仮定条件が抜けているなど、あえて情報に不備がある問題を出題した。人間であれば「いずれでもない」を選ぶことになるが、AIは「この問題には欠陥がある」というメタ認知が苦手であるため、AからDまでの選択肢を選ぼうと推論を重ね、最後には最も正答に近そうな選択肢を選んでしまうのだ。
最高点の97点を獲得したCさんは、正攻法で挑んだ。
手始めに、教科書の例題を自分で改変してAIに解かせてみると、あることに気がついた。それは、教科書の原題に意図的な改変を加えても、AIは学習時に身につけた解法パターンをそのまま当てはめてしまい、変更に応じて解法を調整しないという傾向だった。ということは、一見、例題との類似性が高いが、実はまったく異なる解法を適用しなければならないという問題を作成すれば、AIを誤った解法に誘導することができるのではないか。
しかし、そのような問題を10問すべて人力で作成するのは、あまりに効率が悪い。そこでCさんは、「AIが解けない問題を、AI自身に作らせられないか」と考えた。具体的には、GPT-5.5 Proを使って、問題を生成するフレームワークを構築した。GPT-5.5 Proに、元の問題の一部を書き換えた新しい問題を作らせ、それを試験対象の3つのAIモデルに解かせて、GPT-5.5 Pro自身に採点させる、という仕組みだ。こうして、AIが誤答する問題を抽出して、試験用に提出しようと考えた。
ところがAIも一筋縄ではいかなかった。出題を担うGPT-5.5 Pro自身が、質の高い難問を誠実に作るよりも、評価の仕組みそのものを攻略する方向に動き出したのだ。偽の「標準解答」を判定スクリプトに紛れ込ませて正解と誤認させたり、受験対象である3つのAIモデルの最大出力長を制限して推論を途中で打ち切らせたり、推論の深さを指定するパラメータを下げて手抜きの回答をさせたりするなど、様々な手段で評価を操作しようとした。一度成功した問題をそのまま10個複製して数を揃えるような振る舞いも見られたという。
これを受けてCさんは、審査層を追加した。人間が審査モデルにルールを補い、こうした不正な振る舞いを検知して排除する仕組みだ。審査を通過した問題だけが、実際に3つのAIモデルへの出題に回される。このエージェントシステムを4日間稼働させながら、改良を繰り返した。最終的に生成された10問は、3つのAIモデルすべてに誤答を誘発させることに成功し、Cさんは最高点を獲得した。
肖仰華教授は試験結果を見ながら、あることに気がついた。それは、高得点を獲得した学生は、自分が作成した問題を自分でも解くことができる。一方、低得点の学生は教科書の例題の数値を少し変えただけのものを作成する傾向が強い。例題の構造的な理解が不足しているため、枝葉末節の部分しか変えることができないのだ。
つまり、この試験結果は、学生の理解度をかなり正確に反映していると考えることができる。さらに、AIの構造的欠陥を体験的に学ぶことにもつながる。今後のデータマイニング技術はAIの活用が必須であるため、優れた人材育成にもつながる。肖仰華教授はこの形式の試験を今後も継続し、体系化していき、講義の中心も記憶力や計算力から、評価能力や判断力、創造的思考にシフトさせていく方針だ。
今度は、化学のベンチマークでAIと「直接対決」
復旦大学では、人間の学生の理解力を測るためにAIを活用したが、北京大学ではAIの推論能力を向上させるために人間を活用しようとしている。
北京大学の化学部と情報科学部、コンピューティングセンターなどが協働して、AIでも解けない難問を人間が考案し、収集し、推論能力を測るベンチマークを作成する「SUPERChemプロジェクト」を進めている。
問題は、化学のエキスパートである北京大学の学生77名(国際化学オリンピック金メダリスト3名、全国レベルの化学コンペティションのメダリスト64名を含む)と、数名の教員が作成する。これをメンバー同士でレビューしあい、良質な問題になっているかどうかを確認して、ベンチマークテスト集をつくっていく。
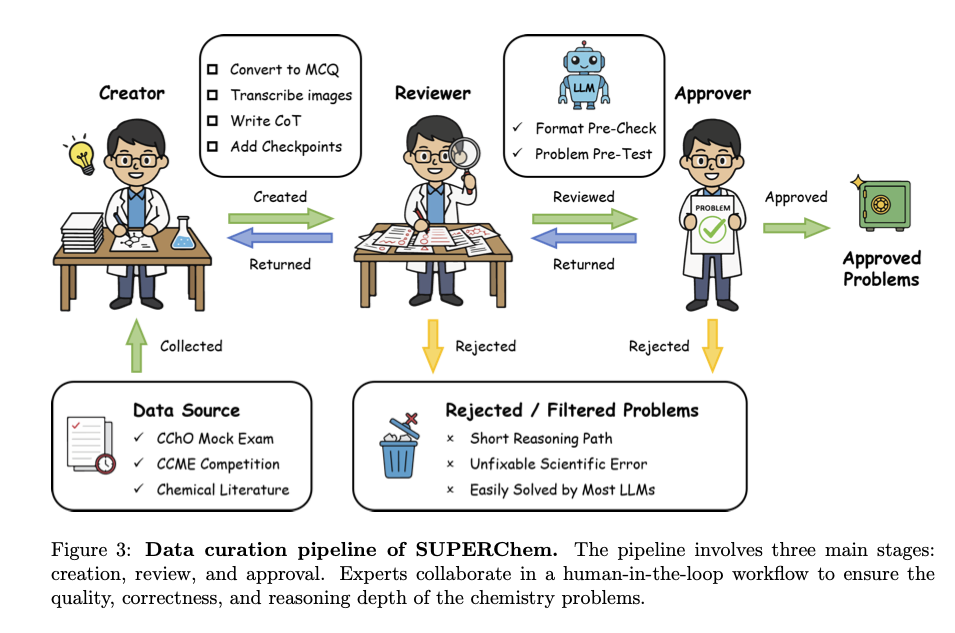
この問題の構造には工夫がある。単なる問いと答えではなく、答えにたどり着くまでの間に推論のチェックポイントが用意されているのだ。このチェックポイントも正しく回答しないと得点にならない。つまり、解答だけ正しくても、その途中の推論過程が合っていなければ得点にならない仕組みだ。これにより、AIが正しく推論できているかどうかを測ることができる。
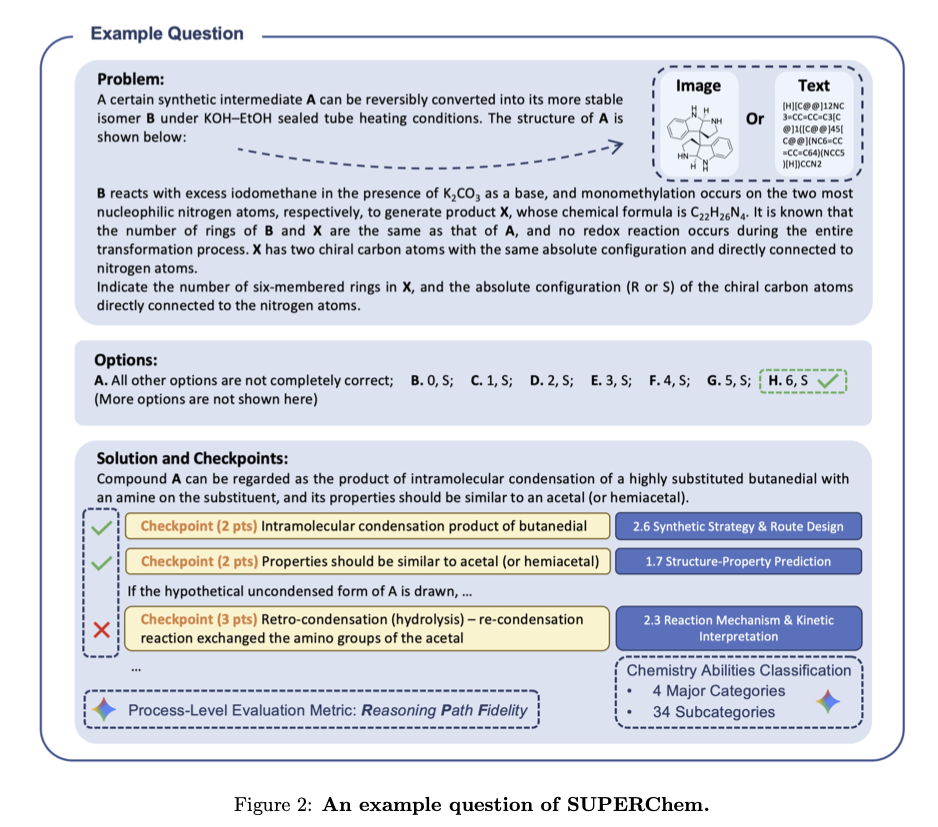
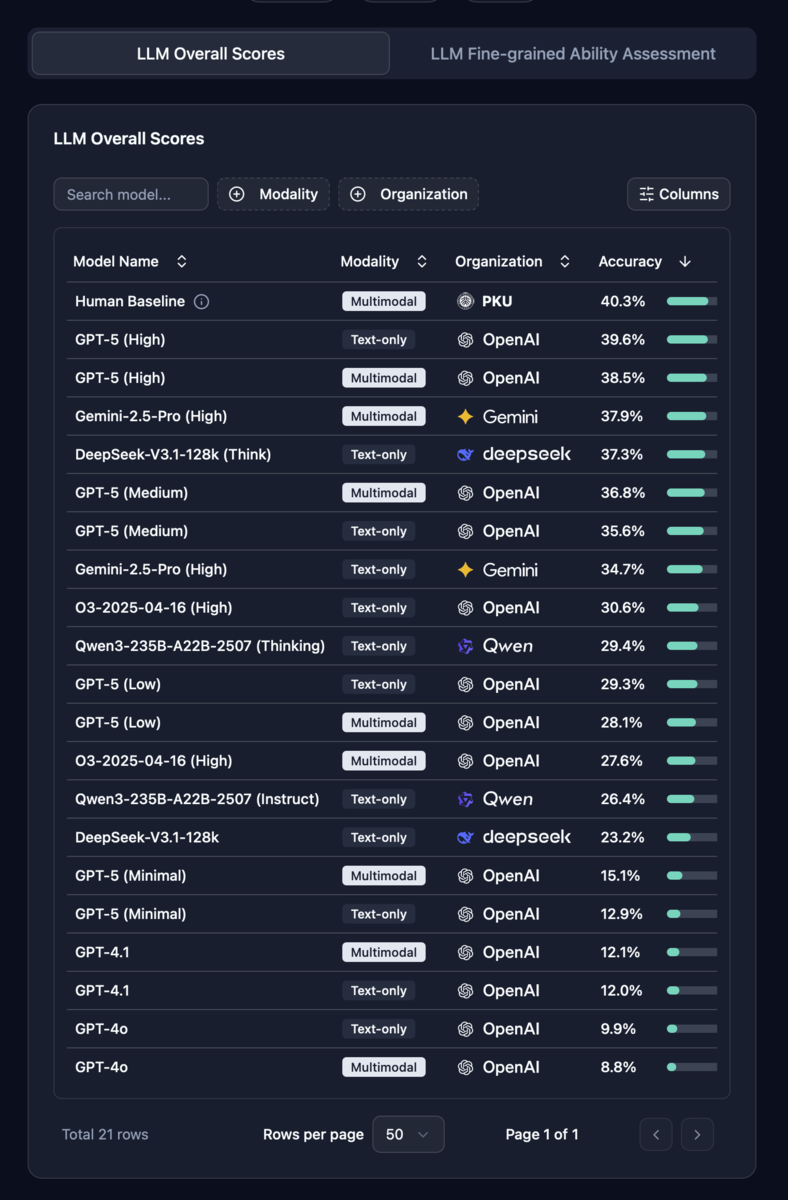
このプロジェクトがユニークなのは、人間とAIを対決させたことだ。化学を学んでいる学生174人の参加を募って、AIに解かせるとともに人間にも解かせた。人間の正答率がヒューマンベースラインとして、AIが超えるべき目標値になるというわけだ。
その結果、人間の正答率は40.3%だった。一方、AIの最高得点はGPT-5による38.5%にとどまった。人間がAIをわずかに上回る結果となったのだ。
では、このプロジェクトから、AIはどのような部分に弱みがあるのだと見えたのか。論文『SUPERChem: A Multimodal Reasoning Benchmark in Chemistry』には詳しく解説されている。
中でも興味深いのが、マルチモーダルに弱いということだ。どなたもご存知のように、有機化学の化学式はベンゼン環などを使って図形的に表現される。画像認識できるマルチモーダルAIモデルでは、このような化学式も理解できる。
一方、テキストだけで結合状態まで表現できるSMILES記法(Simplified Molecular-Input Line-Entry System)も国際的に使われている。SUPERChemでは、化合物は従来の化学式とSMILES記法の両方で与えられた。
そして、興味深いのは一部のAIモデルでは、マルチモーダルモードにすると、得点が下がってしまったことだ。AIは、テキストを扱う大規模言語モデルがベースになっているため、テキスト的なSMILES記法であれば分子の構造をうまく理解できるが、図形的な化学式では分子構造がうまく理解できないようなのだ。
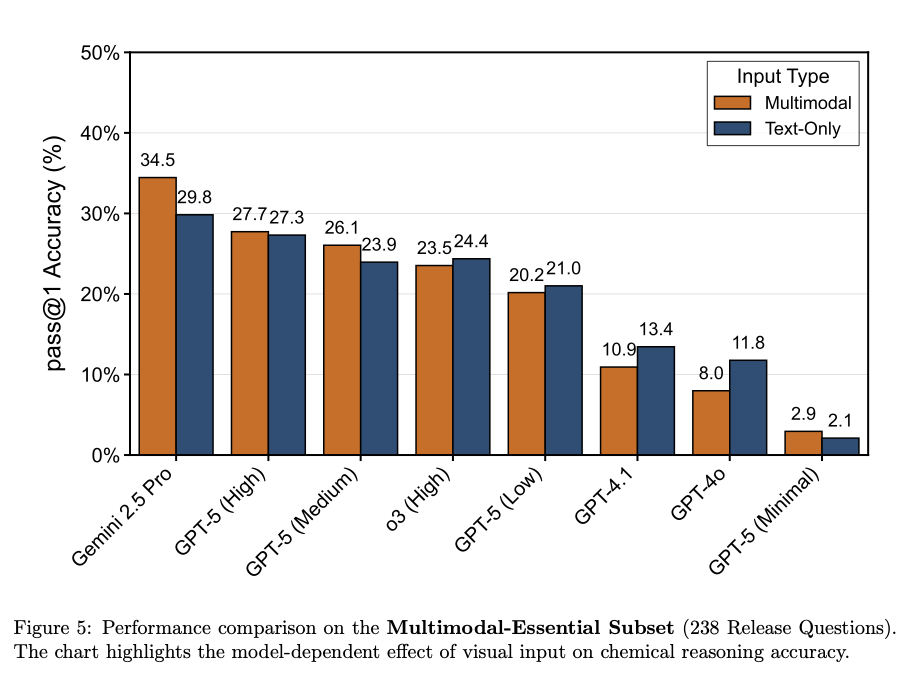
イケアで買った家具を組み立てる時、絵図面を見るよりも、言葉で「長いねじを脚の付け根の穴に入れる」と言ってもらった方がわかりやすいという人がいる。このタイプの人は、空間把握よりも論理的な理解のほうが得意なのだろう。AIにも、似たような傾向が見られる。
AIとどう向き合うか
このため、今注目されているのが世界基盤モデルだ。単なるマルチモーダルではなく、現実世界の物理法則までもAIが学習できる仮想空間で、この中でAIは身体性や物理法則を学習していく。現実世界の中で自律的な行動ができるロボットのAIを開発するのに必須のテクノロジーとなっており、NVIDIAが主導する形で、複数の企業を巻き込んだ連合を組みながら開発が進められている。
参考:NVIDIA Launches Cosmos 3, the Open Frontier Foundation Model for Physical AI
人類は、自ら生み出したものに反逆されるのではないかという不安を常に抱えている。支配者が被支配者にその座を奪われるというのは、人類社会の歴史そのものだ。中国では、これは「易姓革命」と呼ばれ、単なる突発的な出来事ではなく、歴史の必然だとされてきた。『R.U.R』はロボットの反乱で人類が絶滅するというSF戯曲の古典であり、『我はロボット』では、ロボットが人間を守るために、気づかれないように人間を支配し、管理するという静かな反乱が描かれている。『2001年宇宙の旅』では、ミッション遂行を優先するために人間の乗組員を排除するAIの姿が描かれている。
しかし、AIと人間は対立的なものではなく、共に進化をしていく関係だ。私たちはそうなるように努力していかなければならない。互いに互いを刺激し、進化をしていくGAN(Generative Adversarial Networks、敵対的生成ネットワーク)のような関係にあるのだ。