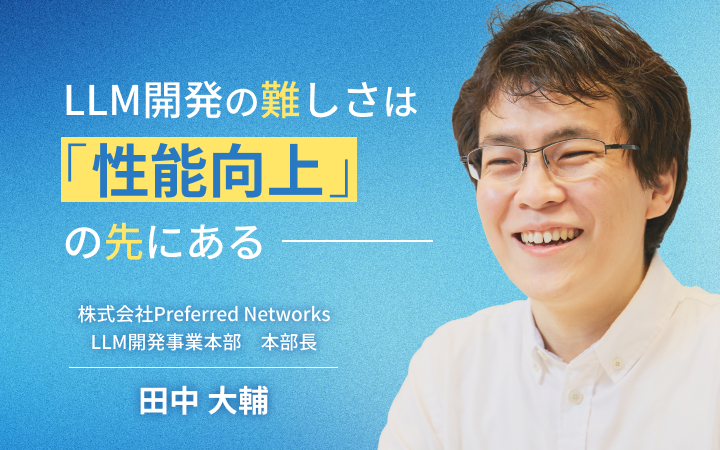
株式会社Preferred Networks LLM開発事業本部 本部長
田中大輔
2015年、株式会社Preferred Networks入社。自社IoT製品の研究開発や企業導入支援、深層学習 コンパイラ開発に従事。エンジニアリングマネージャーを経て、2022年に機械学習基盤担当 VPに就任(当時)。現在は基盤モデル開発を担当する事業部の本部長として生成AI基盤モデル PLaMo™の開発を指揮する。2023年に経営学修士(MBA)を取得。
近年のAI動向について、「米中で開発が先行し、日本は遅れている」と言われがちです。国産LLMは必要だと言われながらも、「ChatGPTやClaudeのような米国のフロンティアモデルを追い抜けるはずがない」という印象を持っている人も多いのではないでしょうか。
しかし、日本にもフルスクラッチで開発され、社会実装が進んでいる国産LLMがあります。その1つが、株式会社Preferred Networks(以下PFN)が開発する「PLaMo」です。
同社のLLM開発事業本部の本部長としてPLaMoの開発を率いる田中大輔さんに取材すると、「米国のフロンティアモデルの開発は資本も計算力も桁違いに大きく、正面から戦っても勝てない」。しかし、AI開発においては「性能を高めること」以上に、「事業として成り立たせること」や「実務のなかで使えるようにすること」のほうが難しいのだといいます。
つまり、AI事業の本質は「AIをつくる」ことより「いかに使ってもらえるようにするか」にある、というわけです。それではなぜ、PFNはコストのかかるフルスクラッチ開発を行っているのか。また、性能の高い米国のフロンティアモデルがあるなかで、どう戦おうと考えているのか。田中さんに聞きました。
AIづくりの最大の難所は「つくる」ではなく「稼ぐ」
――国産LLMをフルスクラッチでつくるうえで、いちばん大変なのはどこですか。
田中:突き詰めると「どう稼ぐか」です。AIはつくること以上にマネタイズが難しく、OpenAIやAnthropicでも苦労しています。
日本国内でいうと、経済産業省とNEDO1の生成AI開発力強化プロジェクト「GENIAC」が立ち上がった2024年ごろは、10〜15社がフルスクラッチでLLM開発に取り組んでいましたが、その後の2年間でほとんどが手を引いてしまいました。
数十人規模の組織で開発を続けられているのは、弊社ともう1社くらい。大手企業に目を移しても数社程度です。ラストマンスタンディングに近い状況になってきたように感じています。
――なぜPFNは、コストのかかるフルスクラッチ開発を行っているのでしょうか。
田中:「他の誰かがつくったモデルを使ったほうがコスパがいい」「海外のオープンウェイトモデルなどを使ってサービスを提供しよう」という考え方もできますよね。
正直に言うと、そのような方向性にも合理性があると思っています。ただ、その場合は開発コストが下がる代わりに、「何かトラブルが起きた際に、学習過程の情報が自分たちの手元にないため、原因がわかりにくい」というデメリットが発生します。
それに対して、自分たちの手でゼロからLLMをつくるとコストはかかりますが、トラブル時に「こういう出力になったのは、こういう学習の順番だったからだ」「データセットにこれが含まれていなかったから、こういう出力ができなかった」と、原因がたどれるようになります。
弊社のPLaMoが目指しているのは、こうした「より安全で信頼できるサービスの提供」です。これはビジネスチャンスにつながる強みだと思っています。
――とはいえ、海外にはChatGPTやClaudeのようなフロンティアモデルがあり、性能で上回るのは簡単ではないはず。どのように勝負しようと考えていますか。
田中:米国のフロンティアモデルの開発に投じられている資本や計算力は膨大で、PLaMoとは1桁も2桁も違います。実際のところ、開発スケジュールも、データセットの集め方も、重視するポイントも、プロダクトの思想も、まったく違うと思います。
そういったモデルと正面から張り合っても勝てません。私たちが勝負どころの一つとして考え、PLaMoで追求しているのは、日本語性能の高さです。
「日本語性能の高いAI」をつくるために、つくるもの
――PLaMoが追求する「日本語性能の高さ」とは、どういったものなのでしょうか。ChatGPTやClaudeでも自然な日本語でチャットできますよね。
田中:そうですね。
私たちは日本語性能を「日本語知能指数」という自社のベンチマーク2で測っていて、「日本語でちょっとした相談をする」「仕事の壁打ちをする」といった用途なら、55~60程度のスコアがあれば違和感なく使えます。
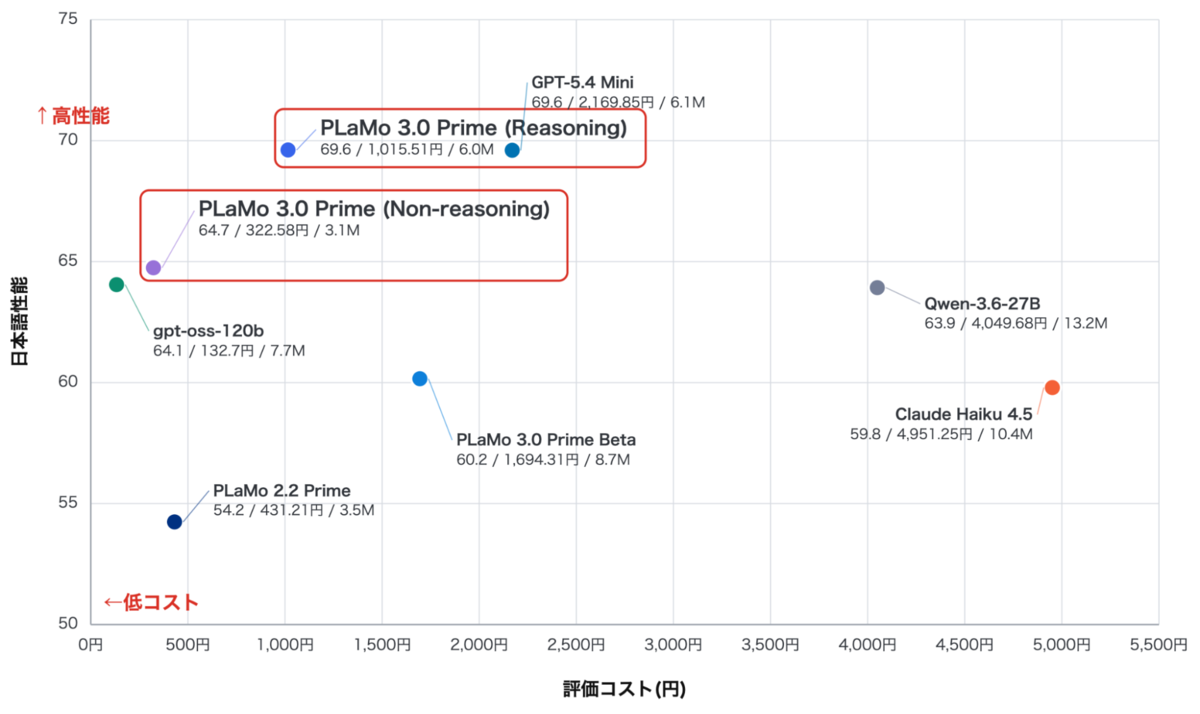
――PLaMo 3.0 Primeのリーズニングモデルのスコアが70くらい、Claude Haiku 4.5の日本語知能指数は60くらいですね。
田中:はい。このスコア差がユーザーの実感として現れるのは、「きちんと敬語で答えられるか」「日本語のメールとして自然か」といったところです。
――イメージとしては、「自分が読むだけの文章」と「他人に見せても問題ない文章」の違いが現れる感じでしょうか。
田中:そうですね。
日本語性能の高さについて他にも定性的な評価を挙げると、ユーザーの方から「PLaMoは国内の地理や観光について聞いたときに、関連する情報を多く返してくれる」「より適切な表現や例文まで詳しく示してくれる」といったフィードバックをいただいています。
ただ、まだベンチマークで測りきれていないところもあって、それは今後頑張っていきたいところですね。
――グラフを見ると、PLaMoは日本語性能が高いだけでなく、コストも低いですね。この特徴は、どこから来るのでしょうか。
田中:まず単純に、海外でつくられたモデルに比べて、学習データセットに含まれる日本語の割合が大きいという背景があります。
海外のモデルの学習データのうち、日本語が占める割合は数パーセント程度と言われています。一方、PLaMoは学習データの約3割が日本語です。その分、行政や法律、財務諸表で使われるような、日本独特の用語にも強くなっています。
――もう一方の「コストの低さ」は、どこから来るのでしょうか。
田中:ひとつ挙げると、日本語にも最適化したトークナイザーを使っていることです。
LLMは文章を「トークン」という単位に区切って処理しているのですが、入力内容が同じでもトークナイザー次第でトークン量が変わってきます。
しかし、現在広く使われているトークナイザーの多くは英語向けで、日本語には合わないことが多いんですね。私たちはこれまで培ってきた自然言語処理などの知見を生かして、日本語に最適化したトークナイザーを独自に開発しています。
日本語を入力したときに海外製のトークナイザーだと100トークンかかるような処理が、PLaMoのそれだと80〜90トークンで済むようになる。この小さな違いが積み重なると、大きなコストの開きにつながる、といったイメージです。
――「日本語に強いAIをつくる」ために、「つくるための土台をつくる」ようなところからやっているんですね。
田中:はい。さらに言うと、日本語向けのベンチマークも自分たちでつくっています。
たとえば「SimpleQA」というベンチマーク。「今いちばん流行っている曲」ではなく、「米国の初代大統領」のような時間が経っても変わらない事実を集め、モデルが正しく答えられるかを計測するためのものなのですが、日本語版がなかったのでつくりました。
それから、指示追従性に関するベンチマークの日本語版もつくりました。AIが、「マークダウン形式で」「10単語以内で」といった指示通りに出力できるかを計測するためのものです。
指示追従性はユーザーの使い勝手に大きく影響します。チャットユーザーから見るとベンチマークとしてはマニアックな部類かもしれませんが、実は、ビジネスの実務においてはとても重要なベンチマークで、まだまだ伸びしろのある領域なのではないかと考えています。
――今後のPLaMoの進化の方向性としてはどのようなものを考えていますか?
田中:今後の進化の方向性のひとつとして力を入れているのが「ディープリサーチ」です。これには、深く推論しながら、検索APIやプレゼン資料をつくるサービスといった外部ツールを次々に呼び出す処理が必要で、それに耐えられるモデルの実現を目指しています。
そこで、2026年6月にリリースしたPLaMo 3.0では、リーズニングモデルを用意しました。また、長い処理に耐えるには一度に扱える文脈も長いほうがいいので、コンテキスト長を2.0の64Kトークンから256Kトークンへと4倍に広げました。
AIと人をつなげるためのフルスクラッチ開発
――AIの話題はどうしてもフロンティアモデルが中心的で、それ以外のモデルの動向については見えにくいところがあります。PLaMoはどんなところで使われているのでしょうか。
田中:たとえば、扱うデータの機密性が高く、外に出せない現場です。具体的には、医療や金融、官公庁、そこと関わりの深い民間企業などですね。デジタル庁も、機密度の高いデータは国内で処理するよう定めていて、そうなると海外のモデルはそもそも使いにくい。性能が足りているだけではダメで、PLaMoのような国産LLMが求められます。
ただ、国産LLMさえあればそういった現場にAIが導入できるかというとそうではなく、お客様のサーバーに載せてオンプレミスで動かしたり、形式がばらばらなデータを整理してデータベースにまとめたり、追加学習で特化モデルをつくったり……と、いわゆる泥臭い取り組みが必要になります。
そして、「モデルをつくる」こと以上に、こちらの「現場で使えるようにする」ことのほうが難しい、と感じています。実をいうと、弊社のLLM事業の主力は、そのためのソリューション事業のほうなんです。
――「AIの社会実装の難しさ」は近年、よく耳にするテーマ。改めて伺いますが、「AIを使えるようにする」だけでも大変なのに、なぜPFNは「AIをつくる」ことを続けているのでしょうか。
田中:繰り返しになりますが、「フルスクラッチでつくらず、海外モデルを使ったほうがコスパがいい」という判断も合理的だと思いますし、多くの企業が撤退していきました。私たちが開発を続けられているのはソリューション事業という出口や、経済産業省などの支援も受けられているからで、まだまだ安泰といえる立場ではないと思います。
それでもフルスクラッチの国産LLM開発にこだわるのは、自社の事業上のメリットだけでなく、自社の利益を超えた意義があると考えているからです。
AIを使いたいだけなら、海外の既成のモデルも利用できる。ですが、「自分たちの手でゼロからつくってみないと得られない知見」というものもあると思います。
国内にAIをつくる事業者がいてこそ、国内に研究の地盤が生まれ、人も育つ。だから、国産フルスクラッチにこだわって戦っていきたいんです。
取材・執筆:川島 昌樹
編集:川島 昌樹、田村 今人
撮影:赤松 洋太